IA que trabaja
El problema: automatizar sin conocer el coste ni los fallos
Automatizar tareas con n8n puede ser muy eficiente, pero si no se mide el coste real ni se detectan los fallos recurrentes, se corre el riesgo de gastar más de lo previsto o de que los errores pasen desapercibidos. Esto puede afectar tanto al presupuesto como a la fiabilidad de los procesos automatizados. Por tanto, es fundamental saber cómo calcular el coste de las automatizaciones y cómo identificar los errores más frecuentes para corregirlos a tiempo.
1. ¿Qué es una ejecución en n8n y por qué importa para el coste?
En n8n, una "ejecución" es cada vez que un flujo (workflow) se ejecuta de principio a fin, independientemente del número de pasos que contenga. El coste de la automatización depende directamente del número de ejecuciones, no de los pasos ni de los usuarios. Según la documentación oficial (n8n Docs), solo las ejecuciones en producción (disparadas automáticamente por un trigger, no las manuales) cuentan para el límite de tu plan.
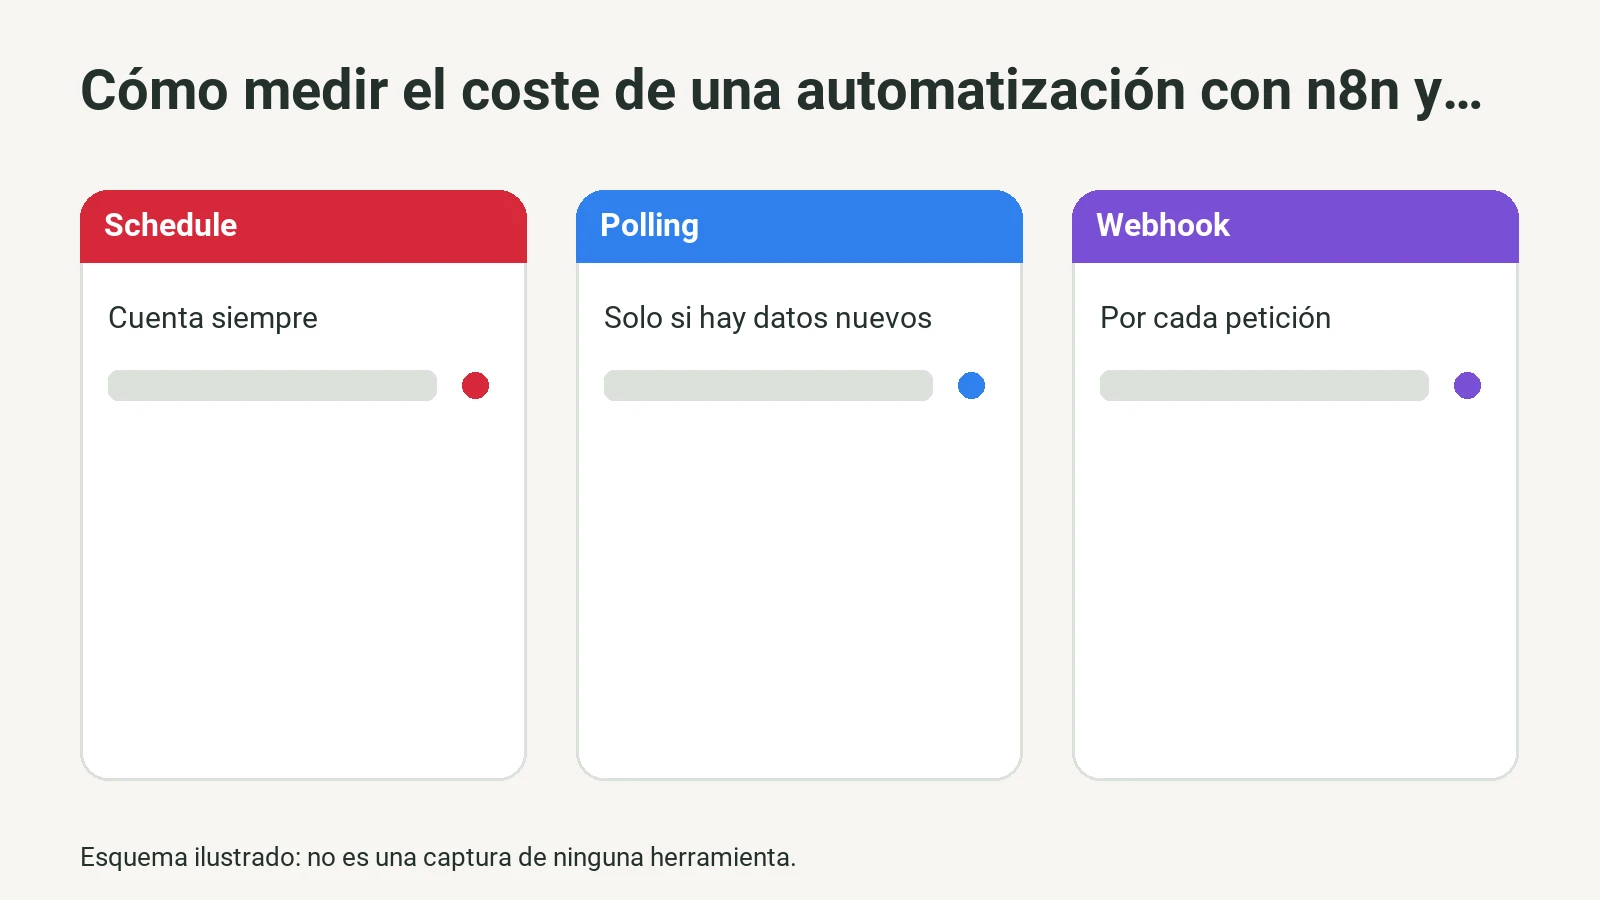
Tipos de triggers y cómo afectan al conteo
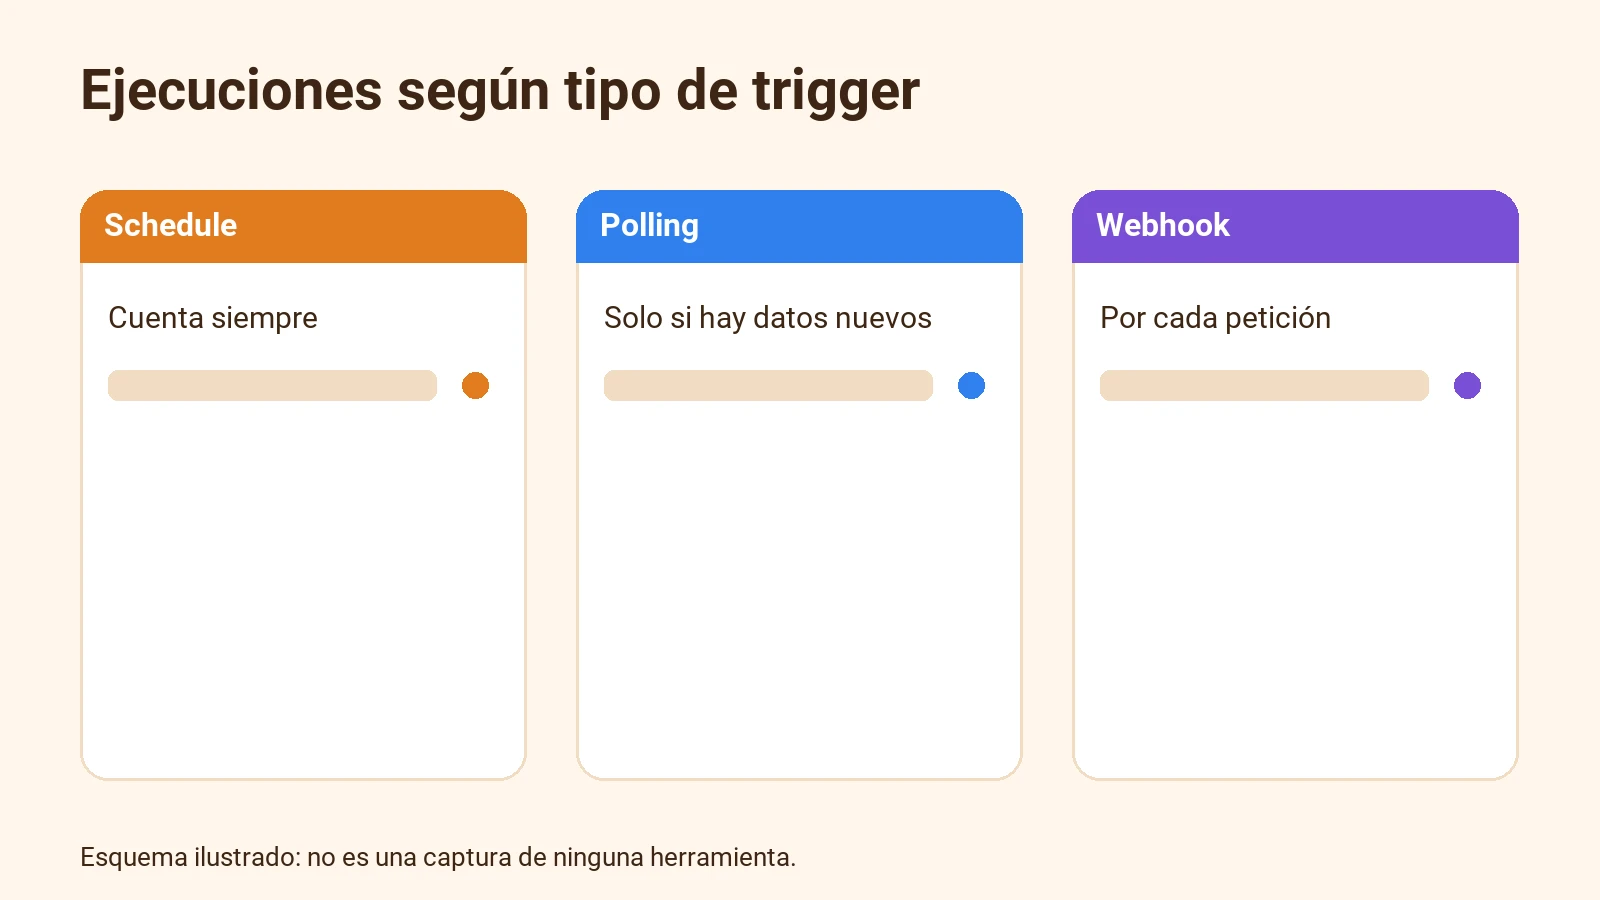
- Schedule Trigger: cuenta una ejecución cada vez que se activa, aunque no haya datos nuevos.
- Polling Trigger (por ejemplo, Google Drive): solo cuenta si encuentra datos nuevos.
- Webhook Trigger: cuenta una ejecución por cada petición recibida.
- Sub-workflows y errores: solo la ejecución principal cuenta, no las subejecuciones ni las de flujos de error.
Esto significa que para estimar el coste, hay que analizar el tipo de trigger y la frecuencia esperada.
Detalle de los triggers y su impacto en el conteo
Cada tipo de trigger tiene un comportamiento específico en cuanto al cómputo de ejecuciones:
- Schedule Trigger: Si programas un flujo para que se ejecute cada hora, se contará una ejecución cada vez, aunque el flujo no procese datos nuevos. Por tanto, si tienes un flujo programado cada hora, tendrás 24 ejecuciones diarias, independientemente del resultado.
- Polling Trigger: Este tipo de trigger consulta una fuente de datos (por ejemplo, una carpeta de Google Drive) y solo cuenta una ejecución si encuentra datos nuevos. Si no hay novedades, no suma ejecución. Esto permite optimizar el consumo de ejecuciones en procesos donde no siempre hay información relevante.
- Webhook Trigger: Cada vez que se recibe una petición HTTP en el webhook, se cuenta una ejecución, aunque la petición esté vacía. Sin embargo, si la petición está tan mal formada que el flujo no llega a arrancar, no se cuenta como ejecución.
- Sub-workflows y flujos de error: Si un flujo principal llama a otro flujo mediante el nodo "Execute Sub-workflow", solo la ejecución del flujo principal cuenta para el límite mensual. Las ejecuciones de flujos de error tampoco suman en el cómputo de ejecuciones.
Este comportamiento está documentado en la guía oficial de ejecuciones de n8n.
2. Cómo calcular el coste de una automatización en n8n
El coste de usar n8n depende del plan contratado y del número de ejecuciones mensuales. Según la página de precios oficial (n8n Pricing), los planes cloud más habituales son:
| Plan | Precio mensual* | Ejecuciones incluidas | Concurrencia | Retención de logs |
|---|---|---|---|---|
| Starter | 20 €/mes | 2.500 | 5 | 7 días |
| Pro | 50 €/mes | 10.000 | 20/50 | 30 días |
| Business | 667 €/mes | 40.000 | 200+ | 365 días |
*Precios orientativos, consulta n8n.io/pricing para actualizaciones.
Para calcular el coste estimado:
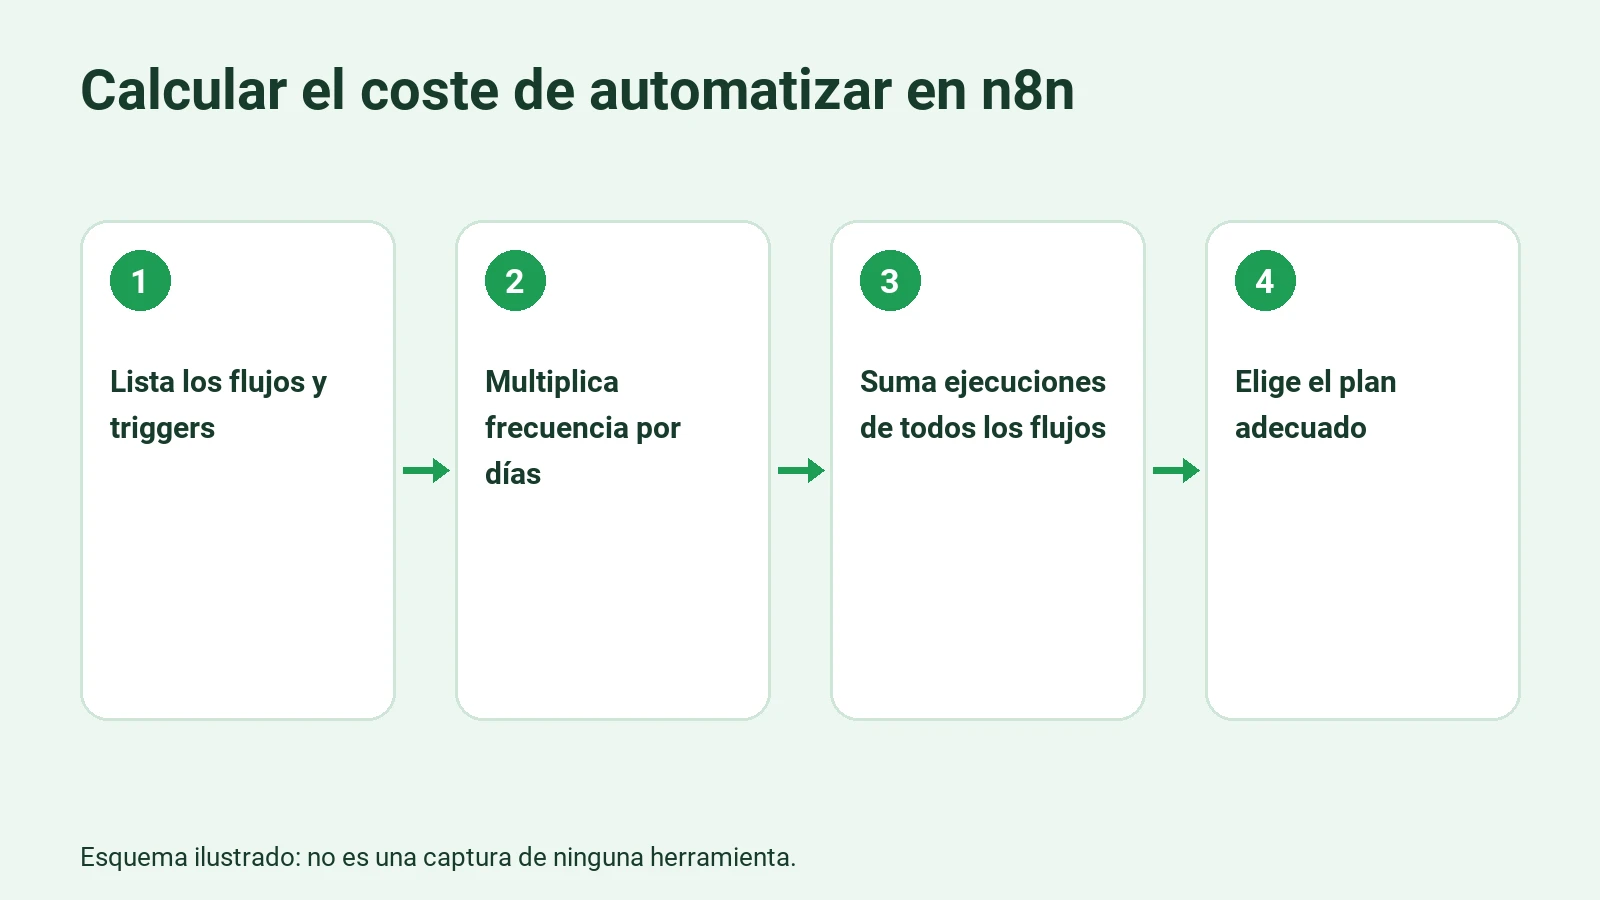
- Lista los flujos que vas a automatizar.
- Identifica el trigger y la frecuencia de cada uno (por ejemplo, diario, cada 5 minutos, por webhook, etc.).
- Multiplica la frecuencia por el número de días del mes para obtener el total de ejecuciones mensuales.
- Suma las ejecuciones de todos los flujos.
- Elige el plan que cubra ese volumen.
Ejemplo propuesto
Supón que tienes:
- Un flujo que se ejecuta cada hora (24 x 30 = 720 ejecuciones/mes).
- Otro flujo por webhook, que se activa unas 10 veces al día (10 x 30 = 300 ejecuciones/mes).
- Un tercer flujo programado cada día (1 x 30 = 30 ejecuciones/mes).
Total: 720 + 300 + 30 = 1.050 ejecuciones/mes. El plan Starter sería suficiente.
Si en el futuro aumentan los triggers o la frecuencia, habrá que revisar si el plan sigue siendo adecuado.
Detalle del cálculo y límites
La clave está en anticipar el volumen realista de ejecuciones. Si subestimas, puedes quedarte sin logs antes de lo previsto, aunque los flujos sigan funcionando. Si sobredimensionas, pagarás por capacidad que no usas. Por eso es recomendable revisar periódicamente el consumo real desde el panel de n8n.
En el caso de webhooks, si tienes picos de actividad, conviene analizar el histórico para detectar si hay días con más ejecuciones de lo esperado. En flujos programados, el cálculo es más predecible.
3. Monitorizar ejecuciones y detectar fallos recurrentes
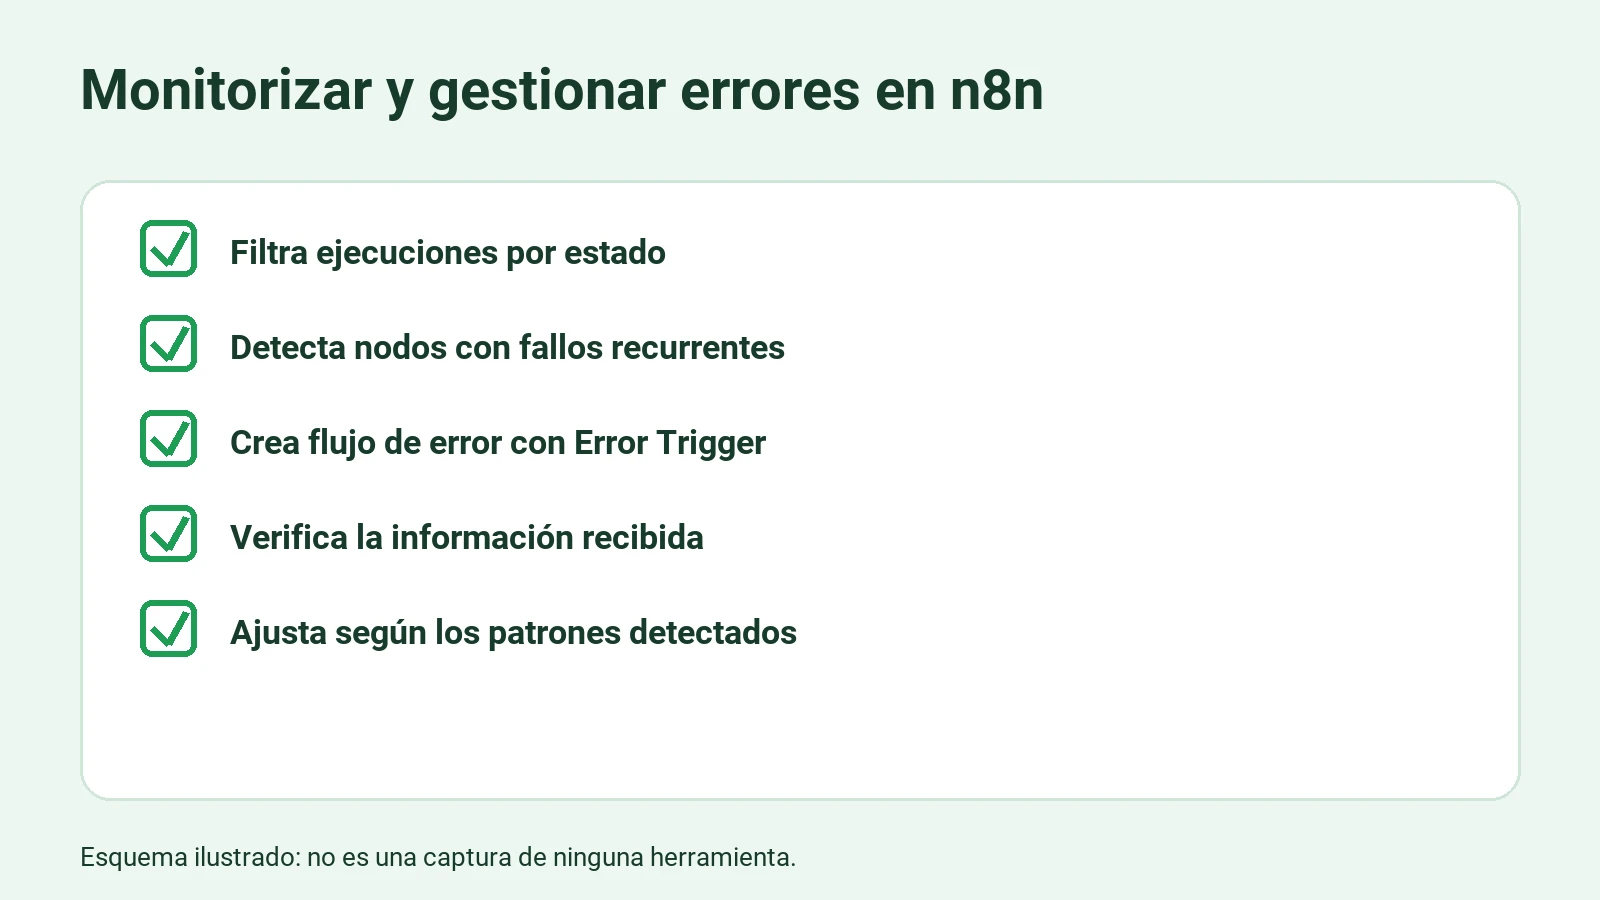
n8n permite revisar el historial de ejecuciones desde el panel de control. Aquí puedes filtrar por flujo, estado (éxito o error) y fecha. Es clave revisar periódicamente este historial para identificar patrones de fallo.
¿Qué buscar?
- Flujos que fallan con frecuencia.
- Errores siempre en el mismo nodo o paso.
- Errores por datos de entrada inesperados.
- Fallos por límites de tiempo o recursos.
La documentación de n8n (n8n Docs) recomienda usar flujos de error para gestionar estos casos y recibir alertas automáticas.
Profundizando en la monitorización
El panel de ejecuciones de n8n muestra para cada ejecución:
- Fecha y hora.
- Estado (éxito o error).
- Flujo implicado.
- Duración de la ejecución.
- Nodo donde se produjo el error (si aplica).
- Mensaje de error.
Esto permite detectar si los fallos se concentran en un flujo concreto, si hay errores recurrentes en un nodo específico o si los errores se deben a datos de entrada mal formateados.
Si detectas que un flujo falla siempre en el mismo punto, es probable que haya un problema estructural (por ejemplo, falta de validación de datos, tiempo de espera insuficiente, etc.). Si los errores son aleatorios, puede deberse a datos externos o a picos de carga.
4. Configuración de flujos de error en n8n
Puedes crear un flujo específico para manejar errores. Este flujo se activa automáticamente si otro flujo falla, permitiendo registrar el error, enviar una alerta o tomar otras acciones (como reintentar o escalar el problema).
Pasos verificables para configurar un flujo de error
- Crea un nuevo flujo con el nodo "Error Trigger".
- Añade los pasos que quieras (por ejemplo, enviar un email o registrar en una tabla).
- En el flujo principal, ve a Configuración y selecciona el flujo de error creado.
- Guarda y prueba forzando un error en el flujo principal.
- Verifica que el flujo de error se ejecuta y registra la información esperada.
Qué datos recibe el flujo de error
El nodo "Error Trigger" recibe información sobre:
- ID y URL de la ejecución fallida (si la ejecución se ha guardado en la base de datos).
- Mensaje de error.
- Nodo donde se produjo el fallo.
- Datos de entrada y salida del nodo.
- Información sobre si el error se produjo en el trigger o en otro nodo.
Si el error ocurre en el trigger del flujo principal, la información disponible es menor, ya que el flujo no llega a arrancar. En ese caso, el flujo de error puede recibir menos detalles.
5. Límites y requisitos de n8n para monitorización y costes
- Solo las ejecuciones en producción cuentan para el coste. Las pruebas manuales no suman.
- El historial de ejecuciones está limitado por el plan: si necesitas revisar errores antiguos, asegúrate de no superar el límite de retención.
- La monitorización avanzada (logs externos, métricas, etc.) solo está disponible en planes superiores.
- En self-hosted, debes gestionar la infraestructura y el almacenamiento de logs.
- Algunos errores pueden no quedar registrados si el fallo ocurre antes de que el flujo arranque (por ejemplo, en un webhook mal formado).
Detalle de los límites según el plan
- El plan Starter guarda hasta 2.500 ejecuciones o 7 días de logs, lo que ocurra antes.
- El plan Pro amplía la retención a 30 días y hasta 10.000 ejecuciones.
- El plan Business permite hasta 40.000 ejecuciones y 365 días de retención.
Esto implica que si tienes un flujo con muchas ejecuciones diarias, puedes perder el historial antes de lo previsto. Es recomendable exportar los logs si necesitas auditoría a largo plazo.
6. Tabla de comprobación: qué revisar y qué hacer si falla
| Qué revisar | Qué hacer si falla |
|---|---|
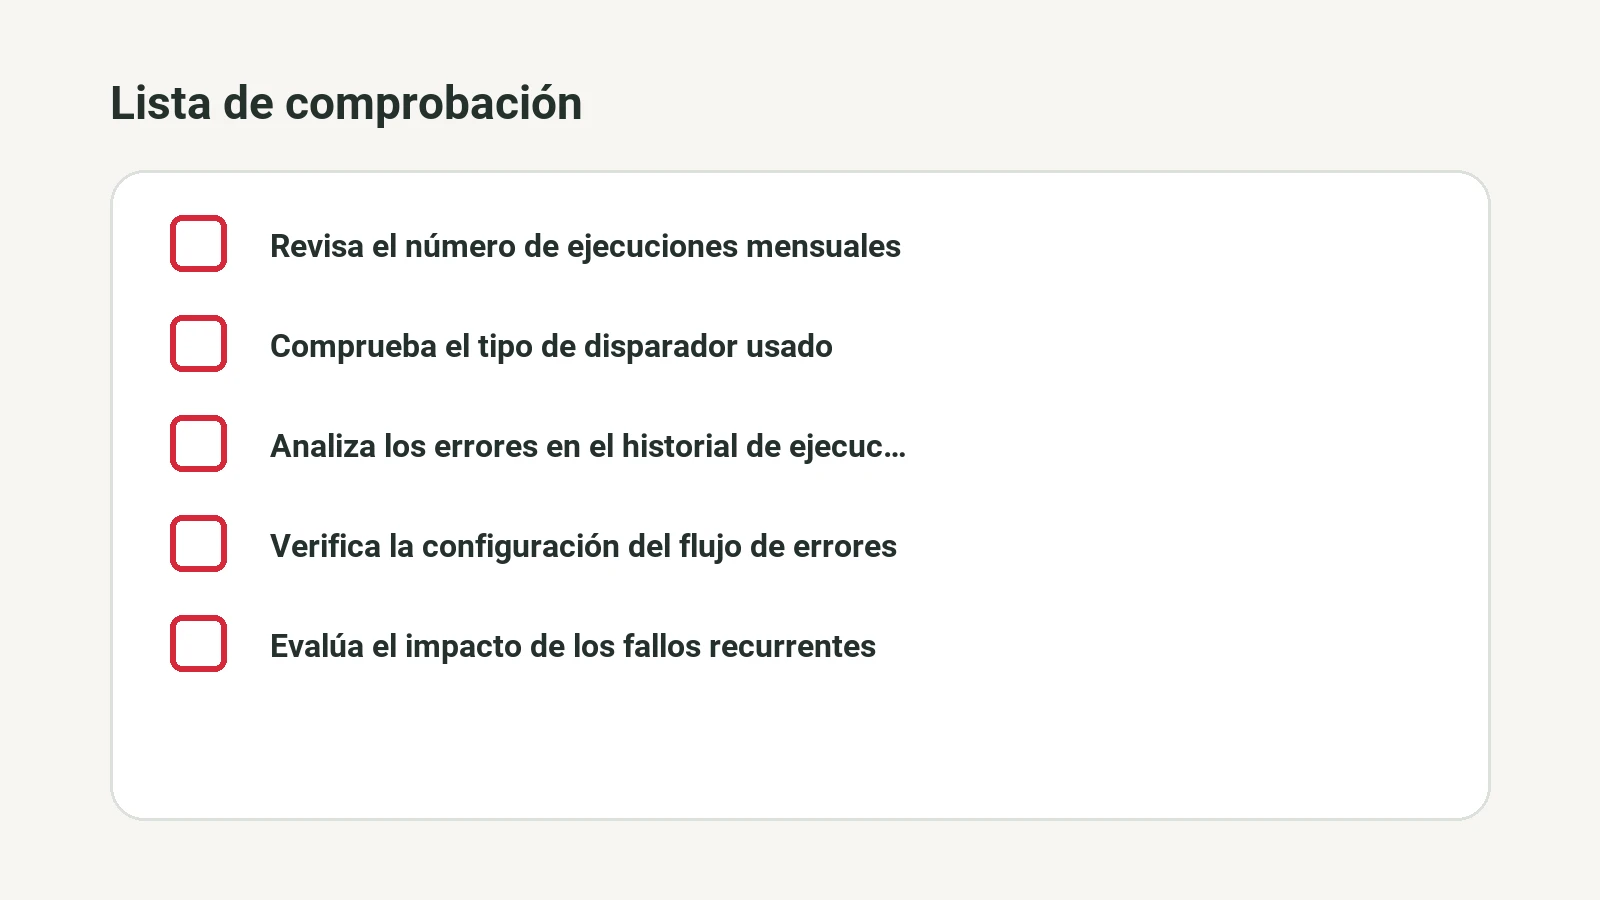
| Número de ejecuciones mensuales | Ajustar triggers o frecuencia |
| Estado de las ejecuciones | Analizar logs y buscar patrones de error |
| Configuración del flujo de error | Revisar que esté bien enlazado |
| Tipo de error (datos, tiempo, etc.) | Mejorar validaciones o dividir el flujo |
| Retención de logs | Exportar logs antes de que se borren |
Esta tabla sirve como referencia rápida para auditar tus automatizaciones y tomar medidas si detectas desviaciones.
7. Preguntas frecuentes
¿Qué pasa si supero el límite de ejecuciones de mi plan?
El flujo seguirá funcionando, pero n8n dejará de guardar el historial de ejecuciones más antiguas. No se detienen los flujos, pero perderás visibilidad sobre ejecuciones pasadas (n8n Pricing).
¿Cómo puedo estimar el número de ejecuciones si aún no tengo datos?
Haz una lista de los flujos previstos, define la frecuencia de cada uno y multiplica por los días del mes. Si usas webhooks, estima el número de eventos diarios. Es mejor sobredimensionar ligeramente para evitar sorpresas.
¿Se pueden automatizar las alertas de error?
Sí. Configurando un flujo de error puedes enviar avisos automáticos por email, Slack u otros canales cada vez que falle un flujo.
¿Qué errores suelen pasar desapercibidos?
Los fallos en triggers que no llegan a arrancar el flujo (por ejemplo, webhooks mal formados) o errores intermitentes por datos inesperados. Por eso es recomendable revisar los logs y configurar alertas.
¿Dónde puedo aprender más sobre automatización y n8n?
Puedes consultar la Academy de IA que Trabaja para formación práctica y ejemplos aplicados.
8. Ejemplo propuesto: detectar y reducir fallos en un flujo de presupuestos
Vamos a desarrollar en detalle un caso hipotético, siguiendo la estructura solicitada: entradas, estados, resultados, errores y una tabla de comprobación.
Planteamiento del ejemplo
Supón que tienes un flujo en n8n encargado de enviar presupuestos automáticos a clientes. El flujo se activa por un webhook cada vez que un formulario web recibe una solicitud de presupuesto.
Entradas
- Datos del cliente: nombre, email, teléfono, detalles del servicio solicitado.
- Fecha y hora de la solicitud.
Estados posibles del flujo
- Éxito: El presupuesto se genera y se envía correctamente al cliente.
- Error por datos incompletos: Falta algún campo obligatorio (por ejemplo, el email).
- Error por fallo externo: El sistema de envío de emails no responde.
- Error inesperado: Cualquier otro error no previsto (por ejemplo, formato de teléfono incorrecto).
Resultados esperados
- El cliente recibe el presupuesto por email.
- El responsable recibe una notificación si hay un error.
- Los errores quedan registrados para su análisis.
Errores detectados
Tras revisar el historial de ejecuciones, observas que aproximadamente el 8% de las ejecuciones fallan. Analizando los logs, identificas dos causas principales:
- Datos incompletos: El formulario permite enviar la solicitud sin email o teléfono. El flujo falla al intentar enviar el presupuesto.
- Fallo externo: El servicio de email ocasionalmente no responde, provocando errores intermitentes.
Medidas tomadas para reducir fallos
- Añades una validación previa en el flujo para comprobar que todos los campos obligatorios están presentes y tienen formato correcto.
- Configuras un flujo de error que registra los fallos y envía una notificación al responsable.
- Reprogramas el flujo para que, en caso de fallo externo, reintente el envío hasta dos veces antes de dar el error por definitivo.
- Revisas mensualmente el porcentaje de fallos y ajustas el flujo según los patrones detectados.
Tabla de comprobación del ejemplo
| Entrada recibida | Estado del flujo | Resultado esperado | Error detectado | Acción correctiva |
|---|---|---|---|---|
| Todos los datos completos | Éxito | Presupuesto enviado | Ninguno | Ninguna |
| Falta email | Error por datos incompletos | No se envía presupuesto, se notifica error | Datos incompletos | Añadir validación y aviso |
| Email correcto, fallo SMTP | Error por fallo externo | No se envía presupuesto, se reintenta | Fallo externo | Reintentar y notificar si persiste |
| Teléfono con formato incorrecto | Error inesperado | No se envía presupuesto, se notifica error | Error inesperado | Mejorar validación de teléfono |
Comprobación hipotética de resultados
- Antes de las mejoras, el 8% de las ejecuciones fallaban, la mayoría por datos incompletos.
- Tras implementar la validación y el flujo de error, el porcentaje de fallos por datos incompletos se reduce casi a cero, quedando solo los fallos externos o imprevistos.
- El responsable recibe avisos automáticos y puede actuar rápidamente.
- El historial de errores permite identificar si hay patrones nuevos (por ejemplo, picos de fallos en el sistema de email).
Limitaciones del ejemplo
Este caso es hipotético y sirve para ilustrar cómo aplicar la monitorización y el control de errores en un flujo real. Los resultados pueden variar según la calidad de los datos de entrada y la fiabilidad de los servicios externos.
9. Comparativa: n8n frente a otros sistemas en gestión de costes y errores
| Herramienta | Cómo mide el coste | Gestión de errores | Facilidad de monitorización |
|---|---|---|---|
| n8n | Por ejecución de flujo | Flujos de error dedicados | Historial y logs detallados |
| Make | Por operación (cada paso) | Manejo básico de errores | Menos granular |
| Zapier | Por tarea (cada acción) | Alertas por email | Panel simple |
n8n destaca por su modelo de coste predecible y por la flexibilidad en la gestión de errores.
10. Recursos y siguientes pasos
- Si quieres externalizar la automatización o necesitas ayuda para monitorizar costes y errores, puedes consultar el servicio de automatizaciones con n8n y Make para empresas.
- Para una visión más general sobre qué procesos automatizar, revisa el artículo Automatizar procesos con IA: guía práctica para pymes y autónomos.
---
Fuentes consultadas:
- n8n Docs: Ejecuciones – Definición y límites de ejecuciones.
- n8n Docs: Gestión de errores – Cómo configurar flujos de error y analizar fallos.
- n8n Pricing – Precios y límites de cada plan.
Fuentes consultadas
- <https://docs.n8n.io/build/flow-logic/handle-errors-gracefully>