IA que trabaja
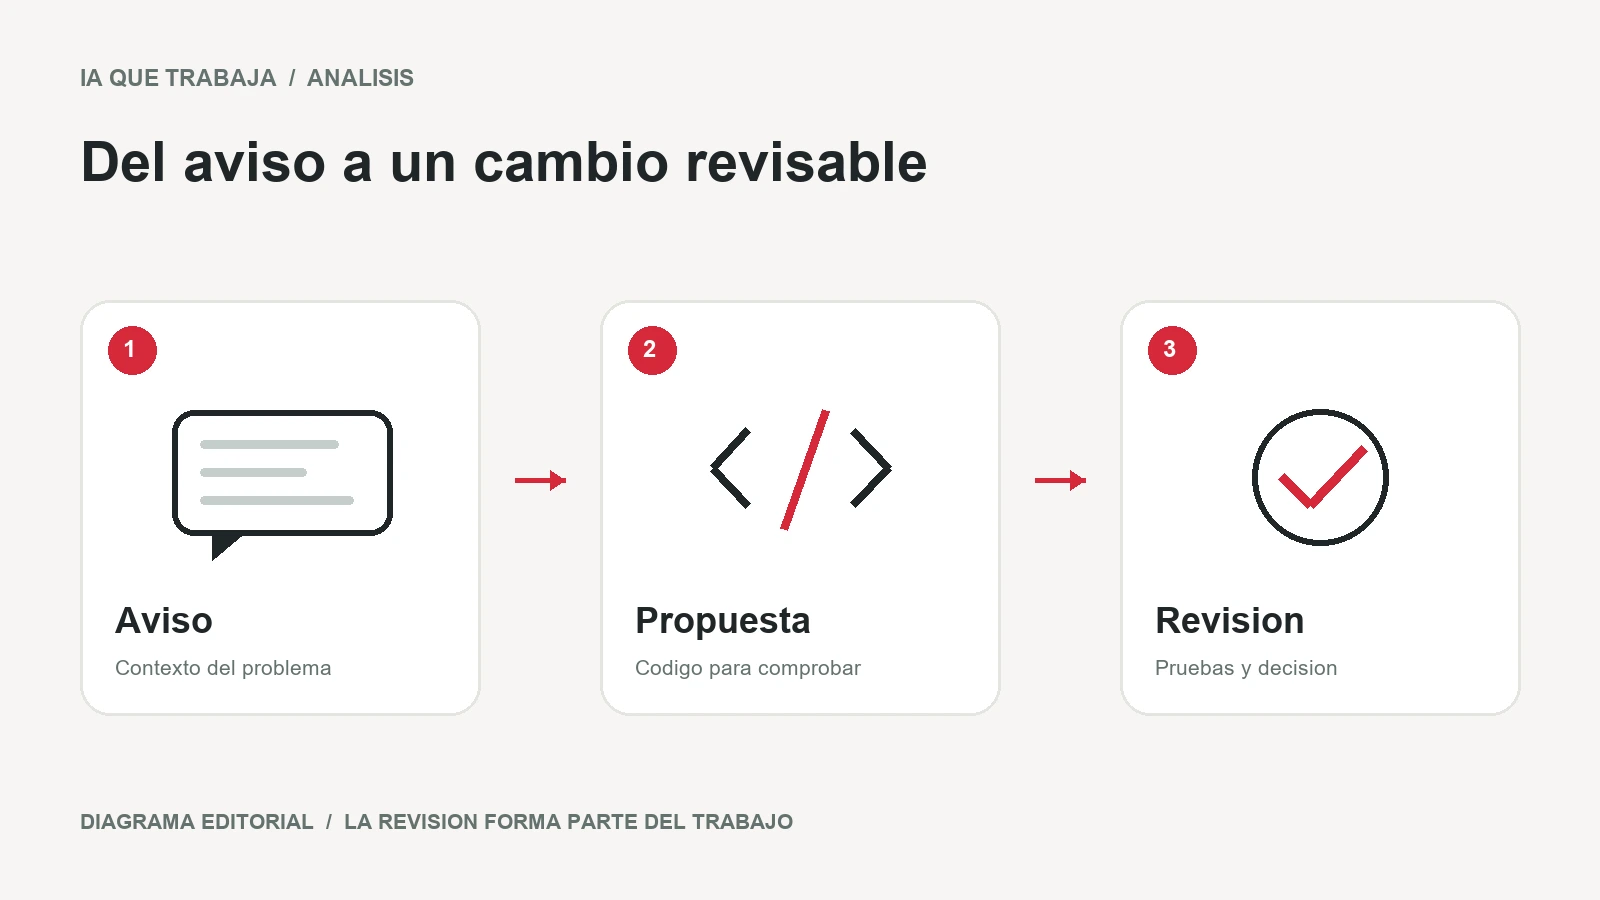
GitHub ha actualizado su aplicación de Teams para acercar los avisos y el trabajo de Copilot. La idea resulta fácil de entender: llega una incidencia, se pide una actuación desde la conversación y el equipo recibe un cambio que puede revisar. GitHub lo anunció el 23 de octubre en su changelog.
Para una empresa pequeña con una web, una aplicación interna o automatizaciones propias, la pregunta es práctica: ¿reduce el tiempo que pasa entre detectar el fallo y tener una solución comprobable? La respuesta depende de cómo se describa el problema y de quién revise el cambio. Abrir una propuesta de código es un paso; demostrar que arregla el error es el siguiente.
Esta guía combina la novedad confirmada con una propuesta de piloto. El ejemplo y las instrucciones de trabajo son un diseño para probar en un repositorio de ensayo; no presento una ejecución real en una cuenta de Teams ni resultados medidos en una empresa.
Qué ha cambiado y por qué merece atención
El anuncio describe una aplicación consolidada que reúne notificaciones y acciones con Copilot. Si ya utilizas GitHub notifications, GitHub indica que debes actualizarla. Para la aplicación antigua, que pasará a llamarse GitHub (deprecated), comunica su retirada el 16 de noviembre. Conviene revisar qué aplicación tiene instalada el equipo antes de diseñar el piloto; el enlace oficial está en el propio anuncio.
La ventaja que interesa comprobar es la continuidad entre el mensaje y el trabajo. En muchos equipos, una incidencia aparece en un chat, alguien la copia en otro sitio, después se busca el repositorio y finalmente se intenta reconstruir lo que quería decir la persona que avisó. Esa cadena puede perder información. Llevar el contexto al lugar donde se propone el cambio puede simplificarla, siempre que el mensaje inicial contenga lo necesario.
Yo aprovecharía esta novedad para revisar el recorrido completo de las incidencias. Si el proceso actual consiste en mandar «esto no va» y esperar, la primera mejora será describir mejor el fallo. La integración tiene más posibilidades de resultar útil cuando ese trabajo previo está resuelto.
Tres conceptos para entender el flujo sin ser programador
Un repositorio es la carpeta de trabajo compartida donde vive el código y queda registrado cómo cambia. Para un negocio puede contener la web, un formulario, un panel interno o una automatización. Antes de conectar herramientas hay que identificar cuál de esos repositorios corresponde al problema.
Una incidencia describe qué falla, qué se esperaba y cómo se puede reproducir. Tener una incidencia útil evita discutir sobre recuerdos: permite comprobar el mismo comportamiento antes y después de un cambio.
Una pull request es una propuesta de modificación. Se puede leer, comentar, probar y aceptar o rechazar. Para quien encarga el trabajo, lo valioso es que hace visible qué se pretende cambiar. Conviene conservar esa separación entre propuesta y publicación, especialmente cuando participa una IA.
Si necesitas una explicación más amplia del papel de los agentes y sus herramientas, tienes la guía de MCP y conexiones con servicios. Es un tema relacionado, aunque esta integración concreta tiene sus propios requisitos.
Requisitos confirmados antes de empezar
La documentación oficial de la integración con Teams señala que necesitas una cuenta de Teams, una cuenta de GitHub y acceso a un plan de pago de Copilot. También exige que el entorno de ejecución en la nube esté habilitado; en una organización puede depender de su administrador. La función figura como versión preliminar pública y puede cambiar.
Para conectar la aplicación, sigue el enlace de instalación de GitHub y las indicaciones de autorización de tu organización. Después se vincula la cuenta de GitHub y se selecciona el repositorio cuando la aplicación lo solicite. No hace falta inventar un procedimiento alternativo ni conceder acceso a todos los proyectos por comodidad.
Hay un detalle relevante al preparar la información: GitHub explica que la conversación del hilo entra en el contexto del agente. Para el piloto, crea un hilo específico con datos ficticios y el problema concreto. Así resulta más fácil saber qué información se le ha facilitado y evaluar si su respuesta la utiliza bien.
Elige una primera incidencia pequeña y comprobable
Una buena primera tarea tiene una salida que cualquiera del equipo pueda verificar. Por ejemplo, un formulario de prueba que admite un campo vacío cuando debería mostrar un aviso. Es una incidencia acotada: puedes preparar una entrada, definir el resultado correcto y repetir la comprobación después del cambio.
Evitaría comenzar con una petición como «mejora la gestión de clientes». Mezcla diseño, decisiones comerciales y comportamiento del programa. Aunque aparezca una respuesta convincente, será difícil decidir si la tarea está terminada. Divídela en un fallo o comportamiento concreto antes de pedir una actuación.
Para seleccionar el caso, usa esta tabla como criterio de trabajo propio:
| Candidato | Qué se puede comprobar | Decisión para el primer piloto |
|---|---|---|
| Un formulario no muestra un aviso al dejar un dato obligatorio vacío | El aviso aparece y el envío incompleto se detiene | Buen candidato si existe un entorno de prueba |
| Una tabla muestra mal una fecha | La misma entrada se representa como se ha definido | Buen candidato si se aclaran formato y zona horaria |
| «El panel va lento» | Falta definir una operación y una medición | Preparar primero una prueba concreta |
| Cambiar precios, permisos y cobros a la vez | Hay varias consecuencias independientes | Dividir el encargo y revisar cada parte |
La tabla no describe capacidades garantizadas de Copilot. Sirve para elegir una tarea cuyo resultado puedas juzgar sin depender de la explicación del agente.
Prepara el mensaje: el trabajo empieza antes de mencionar al agente
Redacta una incidencia que deje poco espacio a interpretaciones. Cuenta qué hace la persona, qué ve y qué debería ocurrir. Incluye una entrada ficticia que reproduzca el problema. Cuando el fallo dependa de un navegador, una fecha o una opción concreta, añádelo.
Este texto es una plantilla de trabajo propuesta para un formulario de ensayo. Adáptala a los datos y pruebas que realmente existan:
Problema: el formulario de prueba permite enviar el campo «empresa» vacío.

Repositorio y zona afectada: [repositorio] / [formulario].
Pasos para reproducir:
1. Abro el formulario en el entorno de ensayo.
2. Relleno los otros campos con datos ficticios.
3. Dejo «empresa» vacío y pulso enviar.

Resultado observado: [comportamiento que he comprobado].
Resultado esperado: mostrar un aviso y detener ese envío.

Propón el cambio mínimo y una comprobación que reproduzca el fallo.
Explica qué archivos modificarías y qué queda pendiente de verificar.
No publiques cambios en producción ni modifiques otros formularios.
Lo importante es rellenar «resultado observado» con una lectura real. Si nadie ha reproducido el fallo, la primera tarea debe ser investigarlo, no aplicar una solución basada en una suposición.
Cómo organizaría una prueba de principio a fin
1. Dejar preparado el estado inicial
Guarda la incidencia y anota cómo se comporta el formulario antes de tocarlo. Conserva el enlace al repositorio y al entorno de prueba. Una captura puede ayudar a explicar el aviso ausente, pero una lista breve de pasos repetibles será más útil para comprobarlo después.
2. Encargar una actuación acotada
Con la aplicación conectada, utiliza la mención que documenta GitHub, @GitHub, y añade el encargo. Especifica el repositorio cuando exista más de uno posible. El criterio de aceptación debe quedar en el mensaje: qué comprobarás para dar por resuelto el problema.
No conviertas el primer intento en una lista de mejoras pendientes. Si aparece otra idea mientras se investiga el formulario, apúntala en una incidencia distinta. De ese modo podrás atribuir cada modificación a una necesidad concreta.
3. Examinar la propuesta recibida
Comprueba que el trabajo corresponde al repositorio y al problema elegidos. Lee el resumen y la diferencia de código. Si una corrección pequeña incluye modificaciones amplias, pide una explicación antes de continuar. Una respuesta larga no compensa un cambio cuyo alcance nadie entiende.
4. Repetir la prueba y comprobar lo que sigue funcionando
Ejecuta los pasos originales. Después prueba un envío correcto: arreglar la entrada vacía no debería impedir rellenar el formulario con datos válidos. Incluye también el caso límite que tenga sentido en tu negocio, como un texto compuesto solo por espacios.
5. Decidir si el cambio se acepta
Una persona responsable compara los resultados con lo pedido. Si algo queda sin comprobar, debe registrarse antes de publicar. El anuncio de GitHub conserva en el equipo las tareas de revisar, probar y unir la propuesta al código principal. El piloto debería mantener esa responsabilidad visible.
Qué revisar aunque el agente diga que está terminado
Mi revisión tendría cuatro preguntas. ¿Se reproduce el problema original? ¿La modificación lo resuelve? ¿Se conserva el comportamiento correcto? ¿El cambio se limita a lo que se pidió? Cada respuesta necesita una evidencia breve: una prueba, una lectura de la interfaz o una explicación del código.
GitHub dispone de protecciones de ramas con las que se pueden exigir revisiones y comprobaciones antes de integrar cambios. Qué reglas concretas puedes aplicar depende de la configuración del repositorio. Revisa esa configuración con la persona que lo administra; no des por hecho que existe una barrera porque el equipo acostumbre a revisar.
Conviene guardar también los fallos del piloto. Si el agente propone un arreglo que supera una prueba demasiado fácil, el resultado útil es descubrir que la prueba estaba mal diseñada. La siguiente versión del procedimiento deberá incorporar el caso que faltaba. Eso proporciona una mejora verificable del proceso, aunque el primer intento no termine en una publicación.
Cómo calcular si compensa sin inventar un ahorro
El coste de esta forma de trabajar tiene varias piezas: la suscripción que corresponda, el uso que se facture según el plan, el tiempo de preparación de las incidencias y la revisión. Consulta las condiciones actuales de los planes de Copilot antes de presupuestar. Esta guía no asigna un precio a una cuenta o contrato que no ha comprobado.
Para la parte de tiempo, mide dos recorridos comparables: desde que se recibe una incidencia bien descrita hasta que hay un cambio aceptado. Separa el tiempo de trabajo del tiempo de espera. Si una persona tarda dos días en abrir una propuesta, no atribuyas ese retraso al modelo ni conviertas toda la espera en horas de trabajo ahorradas.
Ejemplo hipotético: imagina doce incidencias pequeñas al mes. Antes requieren doce minutos de intervención por incidencia; en el piloto pasan a ocho minutos, contando revisión y correcciones. La diferencia sería de cuarenta y ocho minutos al mes. Si preparar y mantener el proceso exige otros treinta minutos mensuales, quedarían dieciocho minutos de mejora neta. Son números de ejemplo, no resultados obtenidos con esta integración.
Ese cálculo ayuda a hacer una pregunta honesta: ¿merece la pena para este volumen y este equipo? Quizá el valor principal sea conservar mejor el contexto, o reducir errores al pasar información. Si eso importa, define cómo lo observarás. No lo conviertas automáticamente en una cifra de rentabilidad.
Cuándo lo probaría y cuándo prepararía otra solución
Lo probaría con un equipo que ya utiliza Teams y GitHub, tiene alguien capaz de revisar código y acumula incidencias pequeñas con información suficiente. En ese contexto se puede estudiar si la conversación y la propuesta quedan mejor conectadas.
Si el negocio recibe los avisos por correo, trabaja con una herramienta distinta o carece de un entorno de ensayo, empezaría por ordenar ese proceso. Puede ser suficiente con registrar la incidencia, asignar un responsable y solicitar los datos que falten. La decisión debe partir del recorrido real del negocio.
Para encargar ese diseño, el servicio de agentes de IA para procesos de negocio permite estudiar qué parte puede ejecutar un agente y qué parte necesita una decisión humana. Si el problema principal es perder avisos entre personas, encaja mejor revisar avisos y seguimiento.
Preguntas frecuentes
¿Merece la pena si no sé revisar código?
Necesitas resolver quién acepta el trabajo. Puedes coordinar la incidencia y comprobar el comportamiento visible, pero eso no sustituye la revisión técnica de una aplicación que utiliza tu negocio. Para el primer piloto, cuenta con la persona que mantiene ese sistema.
¿El ejemplo de esta guía se ha ejecutado dentro de Teams?
No. Es una propuesta de prueba con un formulario ficticio, basada en las funciones documentadas. El diagrama es una ilustración editorial. Las características de la integración se apoyan en las fuentes oficiales enlazadas; no se presentan capturas ni métricas de una ejecución propia.
¿Qué guardo para saber si la prueba salió bien?
La incidencia original, los pasos que reproducen el fallo, el enlace a la propuesta y la comprobación posterior. Añade el tiempo de preparación y revisión si quieres comparar eficiencia. Una explicación de lo que iba a ocurrir no sustituye el resultado observado.
¿Cómo puedo aprender a preparar estos encargos?
Empieza por una tarea pequeña y practica cómo describirla, comprobarla y revisar una modificación. En El Atajo, Academy de IA que trabaja, el aprendizaje gira alrededor de prácticas de IA, herramientas y automatización. Antes de elegir una integración concreta, conviene dominar ese recorrido de encargo, evidencia y revisión.
Fuentes y fecha de revisión
Revisión editorial: 24 de octubre de 2026. La aplicación y sus condiciones pueden cambiar, especialmente mientras la integración siga en versión preliminar.
- Anuncio oficial de GitHub del 23 de octubre: actualización de la aplicación y recorrido de aviso a propuesta.
- Documentación de Copilot en Teams: requisitos, conexión y contexto de las conversaciones.
- Protecciones de ramas en GitHub: mecanismos de revisión y comprobación.
- Planes de GitHub Copilot: punto de consulta de las condiciones vigentes antes de contratar.